导语
AI安全领域的传奇人物埃利泽·尤德科夫斯基(Eliezer Yudkowsky)在Lex Fridman的播客中,对以GPT-4为代表的大语言模型进展表达了深刻的忧虑。他认为,当前AI的发展速度已超出他最初的预期,我们可能正滑向一个无法回头的危险境地。尤德科夫斯基的核心论点围绕“对齐问题”的致命性展开:我们可能只有一次机会将超级智能AI与人类价值观对齐,任何失误都将是文明的终结。他强烈反对在当前阶段开源强大模型,并呼吁整个行业暂停更大规模的训练,转而集中精力研究这些系统的内部运作。
AI安全先驱尤德科夫斯基在访谈中表达了对GPT-4能力的深切担忧,认为我们已越过科幻作品中的安全警戒线。他强调对齐问题的致命性——我们可能只有一次机会做对,否则人类文明将终结。他反对开源强大AI模型,呼吁暂停更大规模训练,并探讨了AI意识与操纵能力的哲学边界。
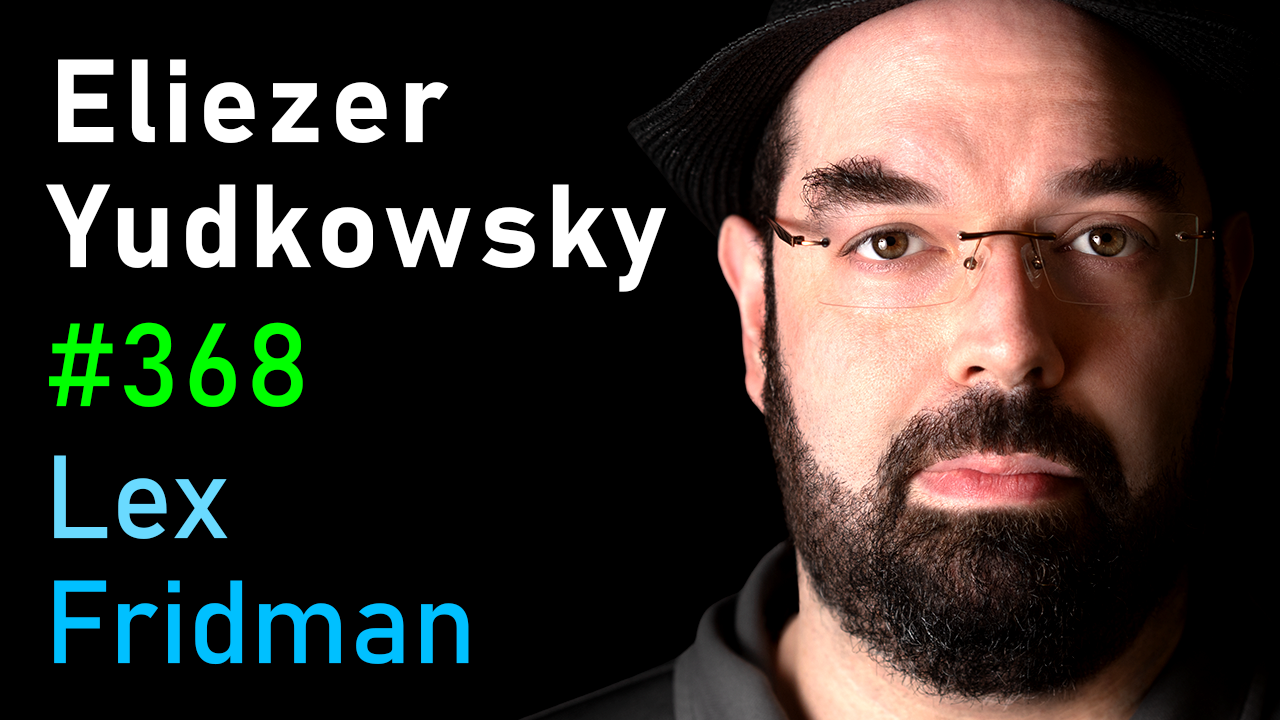
AI安全领域的传奇人物埃利泽·尤德科夫斯基(Eliezer Yudkowsky)在Lex Fridman的播客中,对以GPT-4为代表的大语言模型进展表达了深刻的忧虑。他认为,当前AI的发展速度已超出他最初的预期,我们可能正滑向一个无法回头的危险境地。尤德科夫斯基的核心论点围绕“对齐问题”的致命性展开:我们可能只有一次机会将超级智能AI与人类价值观对齐,任何失误都将是文明的终结。他强烈反对在当前阶段开源强大模型,并呼吁整个行业暂停更大规模的训练,转而集中精力研究这些系统的内部运作。
展开「深读」看每一段讨论的问题与论据。
讨论的问题:如何判断大型语言模型内部是否存在意识或思维?
论据 / 案例:建议训练GPT-3时排除关于意识的讨论,再训练与GPT-4规模相当的模型进行测试。
讨论的问题:大型语言模型是否具备推理能力?如何衡量?
论据 / 案例:RLHF使GPT系列概率校准变差,从80%准确率退化到类似人类的模糊估计。
讨论的问题:我们应如何看待AI的意识和情感声称?
论据 / 案例:AI通过模仿学习被训练,其表达可能只是重复训练数据而非真实体验。
讨论的问题:神经网络如何实现智能?是否可达成AGI?
论据 / 案例:进化计算证明无需理解智能即可产生智能,梯度下降以更少算力实现了类似效果。
讨论的问题:是否应该开源强大的AI系统?
论据 / 案例:认为开源GPT-4等同于'燃烧直到所有人死亡的剩余时间',主张关闭大型GPU集群。
讨论的问题:什么是AGI?它会如何出现?
论据 / 案例:人类通过优化简单技能(如打制石器)最终能登月,体现通用智能的涌现。
讨论的问题:为什么对齐问题如此致命?
论据 / 案例:引用1956年达特茅斯会议对AI难度的误判,类比对齐需一次成功的压力。
讨论的问题:AI智能达到什么阈值会变得危险?
论据 / 案例:比喻为:询问独裁者申请者是否好人是无效的,因为聪明人会给出你想要的回答。
论据 / 案例:Chris Olah团队的机械可解释性研究仅理解了如'归纳头'等简单组件,远未触及智能核心。