导语
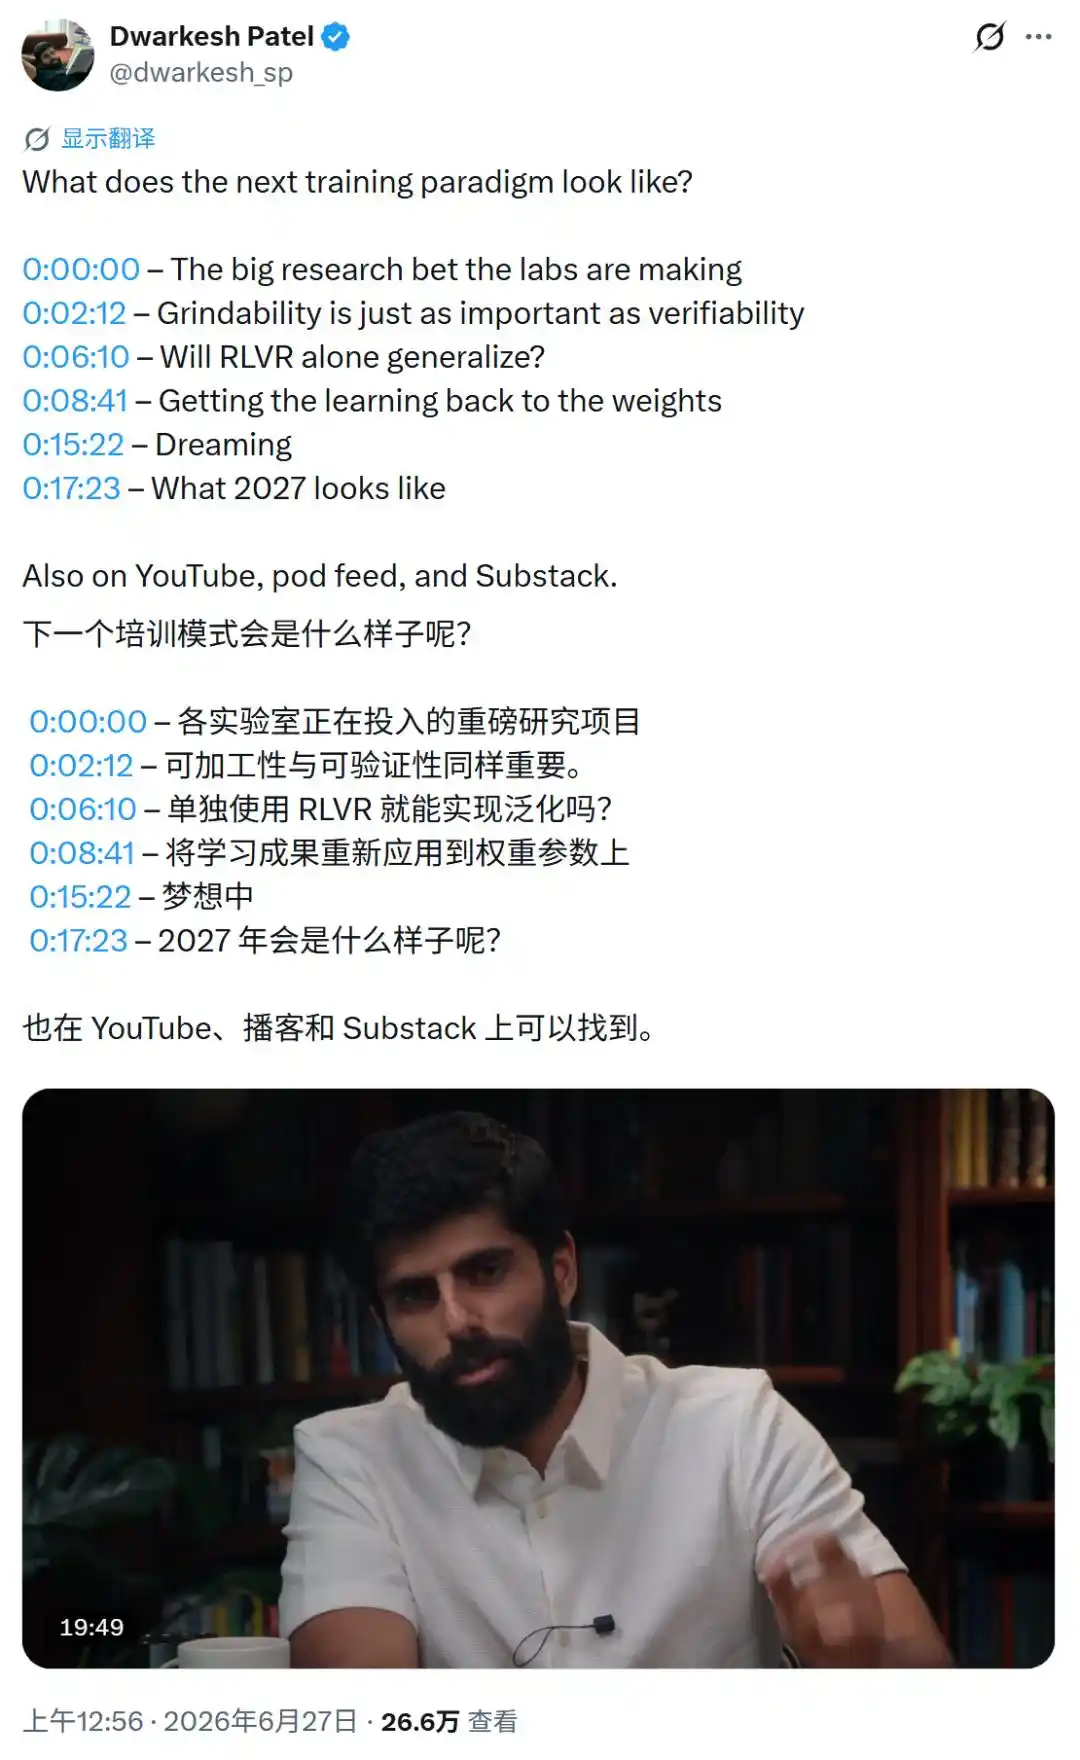
当前AI实验室的核心押注是:通过在大量可验证任务和环境中训练,就能构建出通用人工智能(AGI)。然而,播客主持人兼科技博主Dwarkesh Patel在其最新文章中指出,这种依赖强化学习与可验证奖励(RLVR)的范式存在根本局限。他提出,AI的下一个重大突破将来自“在职学习”——即模型在部署中从真实、复杂且不可验证的世界互动中持续学习并更新自身权重。这需要解决样本效率、持续学习和架构创新等一系列挑战。
本文探讨了AI领域下一个重大突破可能在于“在职学习”。作者认为,当前实验室押注的强化学习与可验证奖励(RLVR)方法存在局限性,尤其是在需要从稀缺、模糊的真实世界互动中学习的领域。文章提出了“在职学习”的必要性,分析了当前在线学习的困境,并探讨了诸如“在线策略自蒸馏”和“做梦”等前沿技术,展望了到2027年底,AI可能通过持续部署和学习实现能力质的飞跃。
当前AI实验室的核心押注是:通过在大量可验证任务和环境中训练,就能构建出通用人工智能(AGI)。然而,播客主持人兼科技博主Dwarkesh Patel在其最新文章中指出,这种依赖强化学习与可验证奖励(RLVR)的范式存在根本局限。他提出,AI的下一个重大突破将来自“在职学习”——即模型在部署中从真实、复杂且不可验证的世界互动中持续学习并更新自身权重。这需要解决样本效率、持续学习和架构创新等一系列挑战。
展开「深读」看每一段讨论的问题与论据。
讨论的问题:实验室实现AGI的核心研究押注是什么?乐观派如何看待当前范式的缺陷?
论据 / 案例:模型在训练时比人类样本效率低百万分之一,但训练成本可摊薄至数十亿用户会话。
讨论的问题:为什么计算机使用领域的AI进步速度远慢于编码等同样可验证的领域?
论据 / 案例:无法在亚马逊网站上并行运行一千个智能体尝试相同的结账流程,因为会被检测和关闭。
讨论的问题:对于需要与世界交互、无法在模拟器中重放的复杂任务,AI训练的核心瓶颈是什么?
论据 / 案例:构建商业、打赢官司、日内交易等任务的验证可能需要数月或数年的现实世界行动才能得出。
讨论的问题:仅靠在可验证环境中训练的RLVR,能否泛化到需要长期规划和现实交互的开放世界任务?
论据 / 案例:Dario Amodei表示,在短上下文长度下训练的模型在提供长上下文服务时性能会下降,暗示短时训练不易泛化。
讨论的问题:为什么真正的持续学习必须将从上下文中获得的知识更新回模型权重?当前面临什么瓶颈?
论据 / 案例:Cursor Tab模型通过预测相同的目标(哪些编辑被接受)进行在线学习,每天处理超过4亿个请求,但这是单一任务。
讨论的问题:什么是“在策略自蒸馏”?它为何可能是实现持续学习的一个更优方案?
论据 / 案例:基于策略自蒸馏,训练基础模型匹配在长会话后做出的预测,无需外部奖励信号。
讨论的问题:什么是“做梦”作为AI扩展的第四个维度?它面临的主要挑战是什么?
论据 / 案例:EfficientZero模型在2小时内通过内部模拟玩大量游戏,可能击败同样是新手的人类。
讨论的问题:到2027年底,基于持续学习范式的AI能力提升路径可能是什么样子的?
论据 / 案例:通过OPSD、做梦或其他技术,将AI在一周协作中学到的所有内容蒸馏回基础模型。